Im Jahr 2026 wurde das traditionelle manuelle Copywriting für B2B-Websites weitgehend durch programmatische Systeme ersetzt. Dennoch stehen 95 % der Unternehmen, die mit einfachen ChatGPT-Wrappern KI-Inhalte generieren möchten, vor erheblichen Nachteilen: Suchstrafen, fehlerhafte Frontend-Layouts, erfundene Codeparameter und keine Sichtbarkeit in KI-Antwortmaschinen (Perplexity, Claude, ChatGPT Search).
Das Problem liegt nicht in den Modellen, sondern im Fehlen einer Engineering-Pipeline. Wenn LLMs Inhalte ohne strenge architektonische Vorgaben generieren, produzieren sie sich wiederholende Klischees, fehlerhafte ASCII-Diagramme, die Markdown-Parser zerstören, unsichtbare Unicode-Wasserzeichen und fiktive API-Endpunkte.
Wir haben den Autonomen GEO-Engine entwickelt: eine 5-phasige Pipeline, die 378 echte Google-Anfragen gesammelt, 7 dichte Themencluster (47 umfassende Artikel) strukturiert und ein Autoritätszentrum mit null Halluzinationen und vollständiger Integrität erstellt hat.
Zusammenfassung
- Warum das Scraping von Google Suggest und People Also Ask-Bäumen direkt bezahlte SEO-Datenbanken mit einer Datenlatenz von 3-6 Monaten übertrifft.
- Das “1 Säule + 2 Satelliten”-Cluster-Blueprint und warum die Verteilung der Veröffentlichungsdaten Suchmaschinen-Crawler-Alarmglocken verhindert.
- 4 strenge Standardarbeitsanweisungen (SOP): Ersetzen von grobem ASCII durch responsive HTML-Karten, null Datenlecks und Konsistenz bei der Währung.
- Automatisierte Vorbereitungsreinigung zur Entfernung unsichtbarer Unicode-Wasserzeichen (Zero-Width-Zeichen) und robotischer Syntax.
- Infrastruktur der Generative Engine Optimization (GEO): BLUF-Formatierung, strukturierte
/llms.txt-Kataloge und dynamische tagbasierte Verlinkung.
1. Kostenlose Ernte der Suchnachfrage ($0 API-Abfall)
Anstatt auf teure Drittanbieter-Datenbanken zu setzen, haben wir einen Python-Harvester eingesetzt, der direkt die Google Autocomplete API und People Also Ask (PAA)-Bäume abfragt.
Durch die Kombination von Seed-Begriffen mit operationellen Modifikatoren (how to, cost of, vs, best way to) und Alphabet-Permutationen (a-z) extrahierte das System in weniger als 4 Minuten 378 verifizierte Long-Tail-Anfragen mit €0 API-Kosten.
Jeder veröffentlichte Leitfaden zielt auf eine aktive, hochintensive Frage ab, die diesen Monat von echten Gründern und Ingenieuren gestellt wurde.
2. Die “1+2” Cluster-Architektur & Veröffentlichungsrhythmus
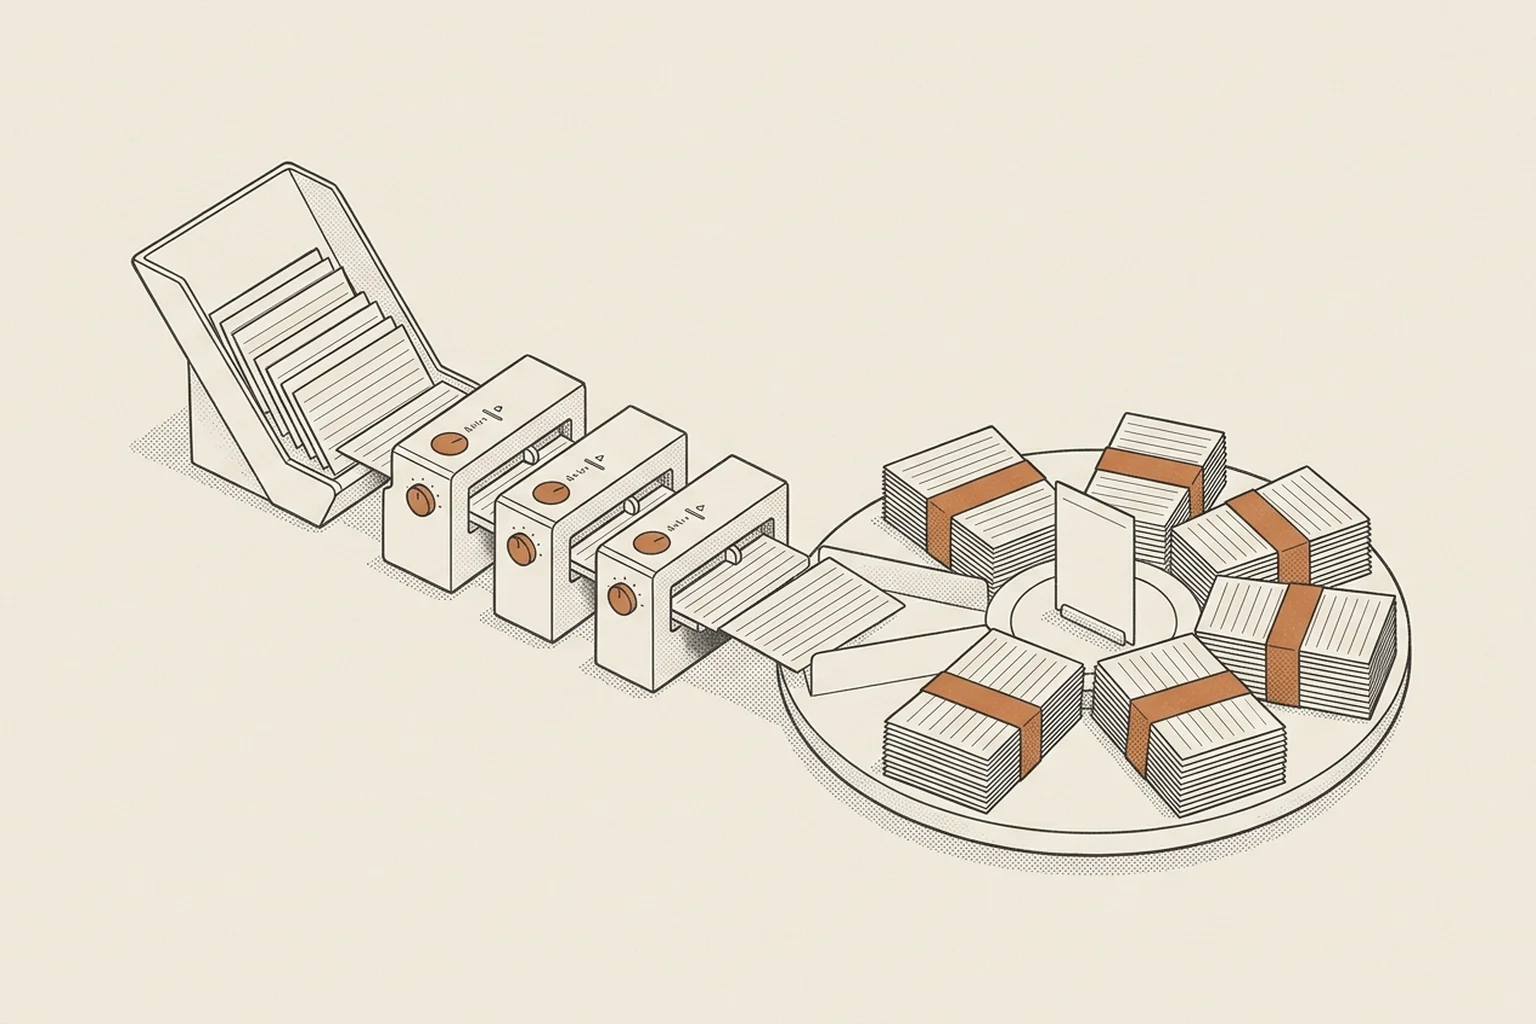
Das Dumpen von Dutzenden von Artikeln an einem Tag auf einer Domain löst Spam-Filter von Suchmaschinen aus. Wir organisierten unsere gesammelten Anfragen in 7 kommerzielle Themencluster:
- Säulen-Hub (Umfassender Leitfaden): Breite, hochintensive architektonische Übersicht (z.B. Automatisierung von WhatsApp CRM mit n8n).
- Satellit A (Technischer Tiefgang): Spezifischer Implementierungsleitfaden (z.B. Transkribieren von WhatsApp-Sprachnachrichten in n8n).
- Satellit B (Abwägung & Vergleich): Protokoll- oder Werkzeugvergleich (z.B. WhatsApp Bot vs Telegram Bot für B2B).
Die Veröffentlichungstermine wurden gleichmäßig über einen Zeitraum von 30 Tagen mit 2-3 Tagen Intervall verteilt, was einen organischen Crawling-Rhythmus für Googlebot erzeugte.
3. Anti-Halluzinations-Engineering-Standards (SOP)
Um typische Misserfolge bei der KI-Generierung zu beseitigen, hielten sich unsere Agenten an 4 verbindliche Engineering-Vorgaben:
- Responsive HTML-Karten statt Monospace-ASCII: Anstelle von dunklen Monospace-Codeblöcken werden alle Workflows als saubere HTML-Containerkarten mit CSS-Flexbox und Schritt-Abzeichen gerendert.
- Null-Indent Markdown-Regel: HTML-Tags werden ohne 4 führende Leerzeichen eingefügt, um zu verhindern, dass MDX- und Astro-Parser sie als rohe Codeblöcke fehlinterpretieren.
- Strenge synthetische Mock-Daten: Keine echten Kundennamen, Produktions-IP-Adressen oder aktiven API-Schlüssel. Alle Beispiele verwenden strikt Mock-Entitäten (
Jane Doe,[email protected],+1 (555) 0100). - Konsistenz bei der Währung (€): Alle Kostenschätzungen und ROI-Tabellen in allen 47 Artikeln sind in EUR standardisiert, um widersprüchliche Finanzzahlen zu verhindern.
4. CleanAI-Wasserzeichenreinigung & Sprachhumanisierung
Sprachmodelle führen häufig subtile Herkunftszeichen ein: unsichtbare Unicode-Zeichen (Zero-Width Spaces \u200B, Zero-Width Joiners \u200D, Soft Hyphens \u00AD) und sich wiederholende strukturelle Klischees.
Vor der Kompilierung scannt unser automatisierter Reiniger den gesamten Markdown-Code, entfernt alle unsichtbaren Zeichen und normalisiert robotische Gedankenstriche in saubere Bindestriche:
# Kernlogik des Wasserzeichenreinigers
ZERO_WIDTH_CHARS = ['\u200B', '\u200C', '\u200D', '\uFEFF', '\u00AD', '\u2060']

def sanitize_text(text: str) -> str:
    for char in ZERO_WIDTH_CHARS:
        text = text.replace(char, '')
    # Normalisiere robotische Gedankenstriche
    text = re.sub(r'\s-\s', ' - ', text)
    return text
5. Infrastruktur der Generative Engine Optimization (GEO)
Im Jahr 2026 erfordert das Ranking in KI-Antwortmaschinen optimierte Datenstrukturen für Retrieval-Augmented Generation (RAG):
- BLUF (Bottom Line Up Front): Die ersten beiden Absätze unter jedem H2 liefern die direkte, umsetzbare Antwort für sofortige Vektorextraktion.
- Die
/llms.txtWissensdatenbank: Ein strukturierter Markdown-Katalog, der alle 47 technischen Themen für KI-Crawler abbildet. - Dynamische Verlinkung: Automatisierte Tag-Matching-Module, die PageRank und Link-Eigenkapital über das gesamte Cluster verteilen.
Fazit: Ein wiederverwendbares Multi-Agenten-Asset
Die Behandlung der Inhaltserstellung als Ingenieurdisziplin ermöglichte es uns, ein 47-Artikel-Autoritätszentrum in einem einzigen Sprint ohne Kompilierungsfehler zu erstellen.
Wir haben diesen vollständigen Workflow in unsere interne geo-seo-engine-Fähigkeit verpackt, die es uns ermöglicht, schnelles, hochautoritäres Wachstum für jeden Kunden oder internen Studio-Projekt zu replizieren.