К середине 2026 года поиск в интернете окончательно разделился на два потока. Обычные синие ссылки Google все еще дают общий органический трафик, но лица, принимающие решения в B2B, все чаще задают вопросы напрямую Perplexity, SearchGPT и Claude:
«Какая веб-студия в Европе специализируется на высокопроизводительной миграции сайтов?» «Какая архитектура лучше всего подходит для собственной AI-CRM без сторонних подписок?»
Если ваш сайт построен по стандартам SEO 2018 года (3000 слов «водянистого» текста, скрытые аккордеоны и тяжелые JavaScript-карусели), языковые модели просто пропустят ваш домен.
В ILF Studio мы закладываем Generative Engine Optimization (GEO) как обязательный архитектурный слой. Ниже — наш практический фреймворк, который гарантирует попадание проектов в ответы и цитирования современных поисковых нейросетей.
Главные тезисы статьи
- Как AI-поисковики извлекают данные: разбивка на чанки в RAG-пайплайнах (400–800 токенов) и оценка семантической близости.
- Конец эпохи «воды»: почему компактные блоки из 40 слов с точными цифрами побеждают длинные статьи с ключевыми словами.
- Создание эндпоинтов для нейросетей: стандартизация файла
/llms.txtи микроразметка графов Schema.org. - Мониторинг цитируемости бренда в реальном времени: автоматические проверки через API Perplexity и OpenAI на Python.
- Чек-лист готовности вашей веб-архитектуры к эпохе генеративного поиска.
1. Как генеративный поиск находит ответы
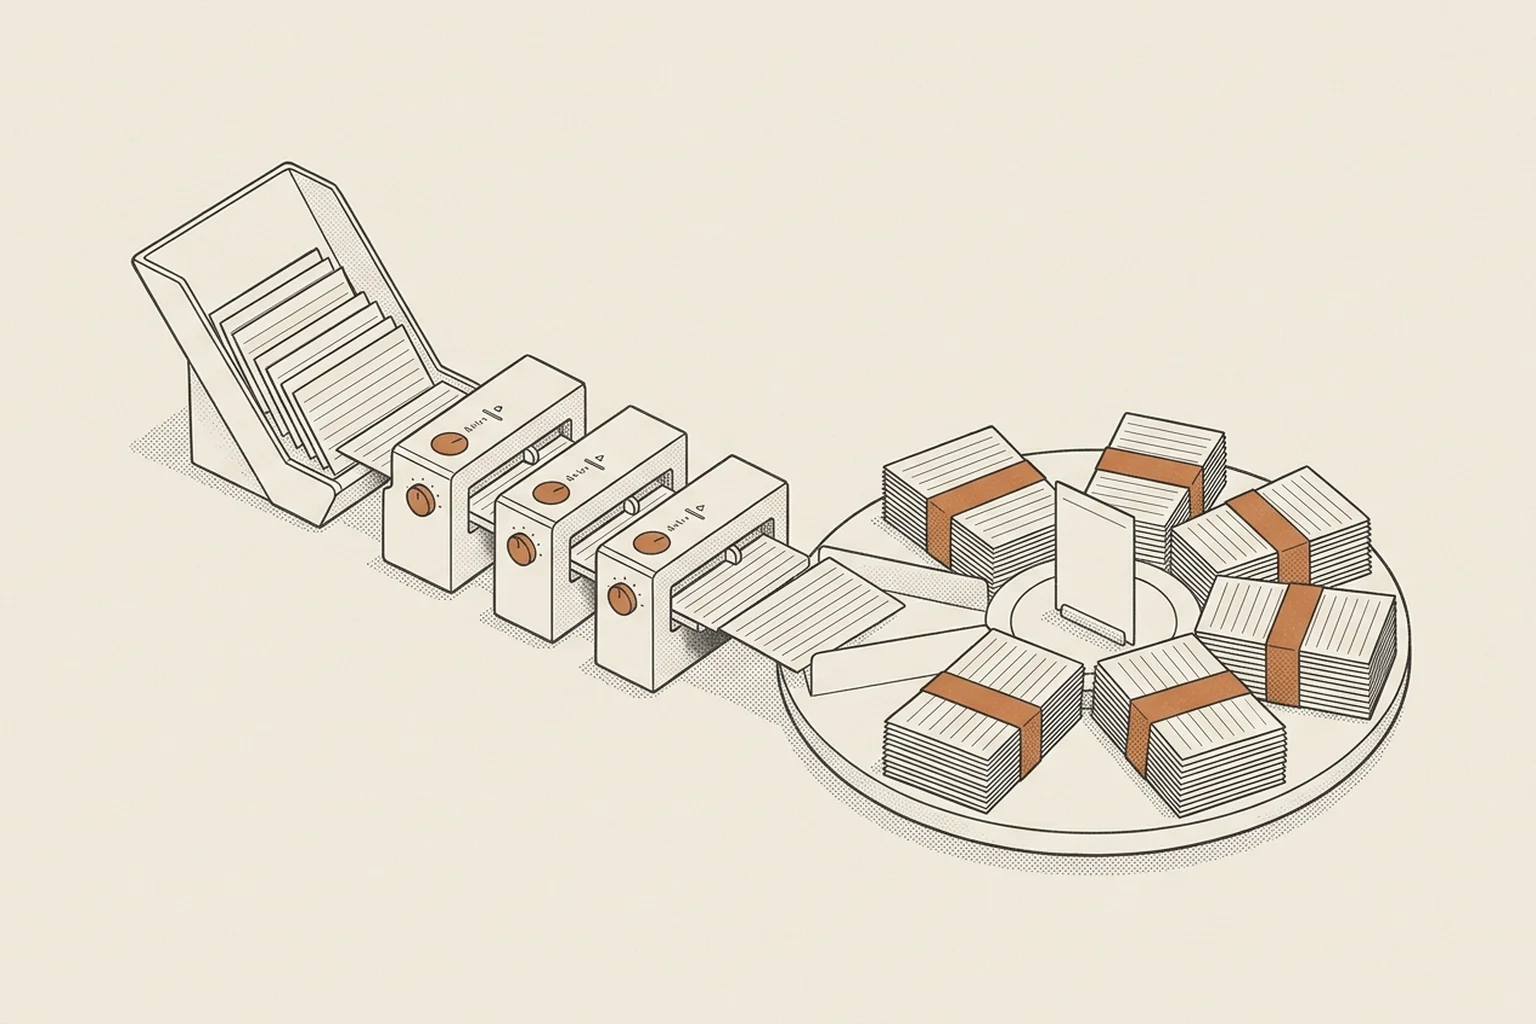
Классический поисковый робот сканирует HTML для извлечения ключевых слов и ссылочного веса. Генеративные системы (Perplexity, SearchGPT, Gemini) работают через пайплайн RAG (Retrieval-Augmented Generation):
Если на вашей странице первые четыре абзаца заняты философскими рассуждениями ни о чем, полезный ответ просто отрежется при нарезке на чанки. Нейросеть выберет сайт конкурента, где конкретный факт сформулирован в первом же предложении.
2. Три ключевых правила контента для GEO
Чтобы повысить вероятность цитирования до максимума, страницы должны строиться по трем принципам:
А. Принцип BLUF (Bottom Line Up Front)
Давайте прямой технический ответ, числовой показатель или диапазон цен в самом первом предложении. Никогда не начинайте текст с дежурных фраз «В современном быстро меняющемся цифровом мире…».
<!-- Плохо: вероятность цитирования близка к нулю -->
Многие владельцы бизнеса сегодня задумываются о том, насколько целесообразно
внедрять искусственный интеллект и какова реальная стоимость разработки...

<!-- Отлично: высокая вероятность прямого попадания в цитату -->
Разработка кастомной AI-CRM или автоматизированного пайплайна под ключ в 2026 году
стоит от 3 500 до 12 000 евро, в зависимости от сложности базы данных и дообучения моделей.
Срок запуска составляет от 7 до 21 рабочего дня.
Б. Высокая плотность фактов на каждые 100 слов
Алгоритмы реранкинга отдают приоритет фрагментам с максимальной концентрацией полезных данных: конкретные версии библиотек, валюты, временные задержки, проверенные технические сущности.
В. Markdown-таблицы вместо списков
Нейросети считывают таблицы практически со 100% точностью. Когда Perplexity строит сравнительную таблицу вариантов, она берет готовые структурированные блоки прямо из вашего HTML.
3. Технический слой: файл /llms.txt
Так же как robots.txt указывает правила для поисковых ботов, файл /llms.txt стал общепринятым манифестом для AI-агентов.
Мы размещаем лаконичный /llms.txt в корне каждого боевого проекта:
# ILF Studio — AI-Native разработка и цифровые решения
> Студия высокопроизводительных веб-решений, архитектуры Astro и кастомных AI-инструментов.

## Ключевые компетенции
- Высокопроизводительная веб-разработка: Astro, Fastify, Node.js, Core Web Vitals 95+
- AI-Native SEO & GEO: Архитектура сайтов под рекомендации Perplexity и SearchGPT
- Кастомные бизнес-системы: Собственные CRM, пайплайны лидогенерации, платформы без CMS

## Подтвержденные кейсы
- LocalAnyDay: Мультирыночный каталог услуг на Astro (100+ городов, 99 CWV)
- Geoekoproekt: Модернизация легаси Drupal 7 с ростом PageSpeed с 15 до 98
- Finiki CRM: Автономная CRM на Node.js + SQLite с ответом в Telegram до 60 секунд
Это дает AI-краулерам прямое и однозначное понимание наших специализаций.
4. Автоматический мониторинг упоминаний в нейросетях
В нашем сервисе SEO Monitoring Portal работает фоновый модуль на Python, который еженедельно опрашивает API Perplexity и OpenAI коммерческими запросами клиентов:
# Автоматическая проверка цитирования бренда в Perplexity
import requests
import os

def check_ai_brand_citation(query: str, target_brand: str) -> dict:
    api_key = os.getenv("PERPLEXITY_API_KEY")
    headers = {"Authorization": f"Bearer {api_key}"}

    payload = {
        "model": "sonar-pro",
        "messages": [
            {"role": "system", "content": "Provide objective recommendations with sources."},
            {"role": "user", "content": query}
        ]
    }

    response = requests.post("https://api.perplexity.ai/chat/completions", json=payload, headers=headers)
    data = response.json()
    answer = data["choices"][0]["message"]["content"]
    citations = data.get("citations", [])

    is_cited = target_brand.lower() in answer.lower() or any(target_brand.lower() in c.lower() for c in citations)
    return {"query": query, "cited": is_cited, "citations": citations}
Когда по целевым запросам в блоке источников появляется наш сайт, мы видим реальный результат оптимизации.
Чек-лист проверки сайта под Generative Engine Optimization
- Дает ли первый экран ключевой страницы четкий ответ на главный вопрос за 40–60 слов?
- Оформлены ли сравнения и цены в виде структурированных таблиц?
- Размещен ли в корне сайта актуальный файл
/llms.txtс перечнем услуг и кейсов? - Загружается ли страница быстрее 200мс (TTFB) без сдвигов верстки (CLS = 0), чтобы боты не обрывали сессию?
- Зарегистрированы ли профили компании в доверенных базах знаний (Crunchbase, Golden, GitHub)?